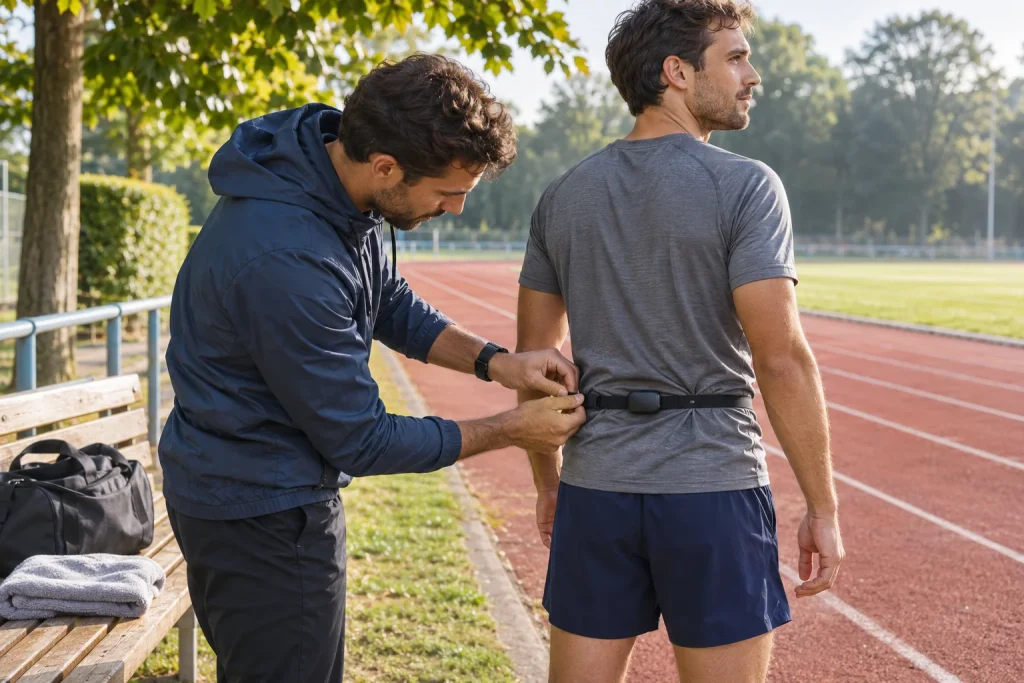
Egy kis derékszenzor a maraton első felében rögzíti a mozgásodat, egy modell pedig ebből keresi a későbbi nagy lassulás előjeleit. Az ötlet izgalmas: a futóritmus időbeli mintázata többet mondhat egyetlen pillanatnyi számnál. Ahhoz, hogy lásd a valódi hasznát, érdemes a szenzortól az előrejelzésig végigkövetni az adat útját, majd egy egyszerű példán megérteni a találati arányokat.
Mit láthat egy derékon viselt szenzor?
A testre rögzített inerciális mérőegység, röviden IMU, a mozgás változásairól gyűjt jelet. Az ebből képzett futóadatok több feldolgozási lépésen át jutnak el az alkalmazásig: a nyers mozgásjelből szakaszokat és lépésekhez kapcsolódó jellemzőket becsülnek. A kijelzett lépéshossz vagy talajkontaktus-idő így nem ugyanaz, mint egy közvetlenül mellé tett mérőszalag vagy laboratóriumi erőmérő eredménye.
A deréktáji elhelyezés előnye a kérdés szempontjából az, hogy a futó mozgásának ismétlődő mintázatát lehet követni hosszabb időn át. Nem csak az érdekes, mennyi egy átlag, hanem az is, hogyan változik a jel a verseny haladtával. Egy kezdetben stabil, majd fokozatosan átalakuló futás más történetet adhat, mint egy ugyanakkora átlagú, de végig hasonló mozgás. Ez a különbség adja a módszer egyik értelmes kutatási irányát.
A készülék ugyanakkor nem látja közvetlenül az összes körülményt. A derékon rögzített mozgásjelből önmagában nem derül ki, mit ettél, milyen volt a hőérzeted, miért álltál meg vagy milyen gondolat miatt változtattál iramot. A szenzor az esemény egy szeletét adja. A legjobb felhasználás ezért olyan értelmezés lehet, amely a mozgási mintázatot a futás többi információjához kapcsolja.
Mi volt az új kutatás konkrét kérdése?
A Miyazaki és munkatársai által közölt vizsgálat japán maratonok első felében rögzített derékszenzoros adatból keresett későbbi, jelentős lassulásra utaló mintázatot. A kiinduló 1437 felvételből a meghatározott lassuló és stabil feltételnek megfelelő, teljes adatsorú 665 eset került a végső elemzésbe. A köztes esetek nagy része kimaradt. A tesztadatokon 73,9%-os pontosságot, 75,8%-os érzékenységet és 70,1%-os pozitív találati arányt jelentettek.
A vizsgálat időbeli görbékkel dolgozott, nem csupán egyetlen átlaggal; a lépéshossz, a talajkontaktus-idő és a becsült függőleges merevség fontos változók voltak a modellben. A szerzők más futócsoportokon történő ellenőrzést és későbbi valós idejű alkalmazást is további feladatként jelöltek meg. Ez kutatási előrejelzés, nem bizonyíték arra, hogy bármely boltban kapható derékszenzor már kész, személyre szabott maratoni riasztást ad.
Mielőtt a százalékot nézed: pontosan mit neveztek lassulásnak?
Egy előrejelzés csak olyan eseményre vonatkozik, amelyet előre meghatároztak. A hétköznapi falnak ütköztem kifejezés több élményt jelenthet: hirtelen kimerülést, fokozatos tempóvesztést vagy egy különösen nehéz szakaszt. Az adatelemzéshez ennél pontosabb szabály kell. Ha két tanulmány más időtartamú és más mértékű lassulást nevez ugyanannak, az eredményeik nem feltétlenül hasonlíthatók össze közvetlenül.
A maratoni késői tempóesést nagy adatbázisban vizsgáló kutatás is a részidőkből felismerhető teljesítményváltozást elemezte. A részidő azonban a futás kimenete, nem az összes mögöttes élettani ok mérése. Egy modell tehát megtanulhatja egy jól definiált tempóminta valószínűségét anélkül, hogy megmondaná, miért következik be az adott futónál.
Olvasóként hasznos két mondatot egymás mellé tenni: ezt az eseményt kereste a modell; ezt az eseményt szeretném én elkerülni vagy megérteni. Ha a kettő nem fedi egymást, a jó találati arány sem válaszol pontosan a személyes kérdésedre. Például egy rövid frissítőponti megállás vagy végig kicsit lassabb verseny más jelenség, mint egy tartós, nagy késői tempóvesztés.
 Kép nagyítása
Három találati arány három külön kérdésre válaszol
A pontosság azt kérdezi, az összes értékelt esetből mennyit sorolt helyesen a modell. Az érzékenység, más néven recall, a valóban bekövetkezett események közül megtalált rész aránya. A pozitív találati arány, vagy precision, pedig azt mutatja, a modell által jelzett esetekből mennyi igazolódott. A scikit-learn hivatalos értékelési dokumentációja is külön mutatóként kezeli ezeket.
Futóként három külön aggodalom kapcsolódhat hozzájuk. Szeretnéd, ha a rendszer általában helyesen osztályozna; nem szeretnéd, hogy elszalasztja a valódi problémát; és azt sem, hogy túl sok hamis figyelmeztetés változtassa meg a futásodat. Egyetlen százalék nem tudja mindhárom szempontot egyszerre összefoglalni. Az, hogy melyik hiba zavaróbb, az alkalmazás céljától is függ.
Fontos nyelvi különbség: a 70%-os pozitív találati arány nem jelenti automatikusan azt, hogy neked 70% eséllyel lesz gondod. A mutató egy adott adatcsoporton és döntési szabály mellett képzett arány. Egy személyre kiírt valószínűség megfelelő ellenőrzése külön feladat lenne. A csoportos modellértékelést ezért ne fordítsd át közvetlenül személyes jóslattá.
Egy kitalált ezres példa megmutatja a hamis riasztás súlyát
Az alábbi számpélda kizárólag a fogalmak megértésére készült, nem a maratoni kutatás eredményének újraszámolása. Tegyük fel, hogy ezer futásból száz felel meg a keresett lassulási eseménynek, kilencszáz pedig nem. Egy képzeletbeli modell a százból nyolcvanat jelez helyesen, húszat elszalaszt. A kilencszáz többi futás közül kilencvenre tévesen riaszt, nyolcszáztízre helyesen nem jelez.
| A képzeletbeli modell | Az esemény bekövetkezett | Az esemény nem következett be |
|---|---|---|
| Jelzést adott | 80 helyes jelzés | 90 téves riasztás |
| Nem jelzett | 20 elmaradt jelzés | 810 helyes elutasítás |
A pontosság ebben a példában (80+810)/1000, tehát 89%. Az érzékenység 80/100, vagyis 80%. A pozitív találati arány viszont 80/(80+90), körülbelül 47,1%. A magasnak hangzó teljes pontosság mellett így a riasztások több mint fele téves lenne. Ennek megértéséhez nem kell bonyolult algoritmus: az esemény gyakorisága és a négyféle kimenet száma már sokat elmond.
Ha a jelzés csak egy utólagos elemzői megjegyzés, más lehet a következménye, mint ha a verseny közben sürgős tempóváltást javasolna. A példából nem az következik, hogy minden riasztás haszontalan. Az következik, hogy a használati értékhez tudni kell, hány téves és hány elmaradt jelzés várható az adott környezetben. A számot a döntéssel együtt érdemes értékelni.
Miért fontosak a köztes futások?
Képzelj el egy futóklubot háromféle maratoni lefolyással. Van, aki végig hasonló iramot tart, van, aki jelentősen és tartósan visszaesik, és van, aki kisebb hullámzással lassul, majd rendeződik. Ha egy elemzés csak az első és a második csoportot tartja meg, egy jól körülhatárolt szélsőségesebb különbséget tanul. Ez hasznos kezdet lehet, de a harmadik csoport futói ettől még ott lesznek a következő valódi versenyen.
A hétköznapi használatban a rendszernek a bizonytalan vagy köztes esetekkel is kezdenie kell valamit. Adhat például kevésbé magabiztos jelzést, vagy jelezheti, hogy az adat nem illik a korábbi értékelési helyzethez. Az ilyen visszafogott kimenet gyakran őszintébb, mint minden futásra határozott igen–nem választ erőltetni. A kutatás olvasásakor ezért a kizárt és hiányos esetek száma is informatív, nem csak a végső találati arány.
Az ismeretlen futó a valódi próba
Egy modell tanulóadatból épül fel, majd olyan adaton kell értékelni, amelynek eredményét a tanulás során nem használta. A scikit-learn hibaforrásokról szóló útmutatója külön tárgyalja az adatszivárgást: ha a tesztből származó információ beleszól az előkészítésbe vagy a tanításba, az értékelés túl derűlátó lehet. Ez általános módszertani szabály, nem állítás arról, hogy az adott maratoni vizsgálat hibásan járt volna el.
A következő kérdés még ennél is tovább megy: mi történik másik versenyen, más időjárásban, más futókkal és más készülékkel? Egy új környezetben kapott ellenőrzés segít megmutatni, mennyire vihető át a kapcsolat. Ha az eredményt mindig ugyanannak az adatgyűjtésnek a keretei között nézed, nem biztos, hogy a váratlan valódi helyzetek is megjelennek benne.
Futóként ebből egy egyszerű kérdéssor lesz. Kik voltak az eredeti résztvevők? Mennyire hasonló a feladatuk az enyémhez? Milyen szenzor és rögzítési mód kellett? Ellenőrizték-e a rendszert új futásokon? Ezek a kérdések jobban közelítenek a gyakorlati haszonhoz, mint a legnagyobb százalék kiválasztása egy sajtóhírből.
Jelző változó és javítandó mozgás nem ugyanaz
Ha egy mozgási jellemző segít előre jelezni egy eredményt, attól még nem biztos, hogy annak közvetlen megváltoztatása javítja az eredményt. Egy hosszabb kontaktusidő lehet egy összetettebb futásminta része, nem feltétlenül önálló ok. A modell azt tanulja, mi jár együtt a megadott kimenettel az adatokban. A beavatkozás hatását más felépítésű vizsgálatnak kellene ellenőriznie.
Egy hasonlat segít: az esernyők látványa jól jelezheti az esőt, de az esernyők eltüntetése nem szünteti meg a csapadékot. A futómozgás ennél összetettebb, de a logikai különbség hasonló. Ha egy algoritmus fontosnak talál egy mérőszámot, az érdekes vizsgálati kérdést adhat az edzőnek. Nem lesz belőle automatikusan olyan utasítás, hogy minden futónak rövidebbet kell lépnie vagy más merevséget kell produkálnia.
A maratonisták élettani tartósságát vizsgáló laboratóriumi munka más típusú méréssel közelítette meg a hosszú teljesítmény változását. A mozgásjel, a pulzus és a laboreredmény külön információforrás. Együtt árnyalhatják a képet, de egyik sem helyettesíti automatikusan a másikat. A feladat megértése több jel összerendezését igényli.
 Kép nagyítása
Milyen visszajelzés lenne tényleg használható?
Képzelj el egy óvatos, jövőbeli felhasználói üzenetet: a mostani mozgásmintád eltér a korábbi, hasonló futásaidtól; nézd át a tempót és a körülményeket. Ez más, mint az a kijelentés, hogy biztosan falnak fogsz ütközni. Az első megfigyelést ad és döntési teret hagy, a második túlzott bizonyosságot sugall. A jó visszajelzésnek az adat megbízhatóságát és a jelzés bizonytalanságát is közölnie kellene.
Az üzenetnek a futóhelyzethez is illeszkednie kell. Egy utólagos edzői elemzésben van idő görbéket összevetni és több magyarázatot megvizsgálni. Verseny közben rövid, világos és arányos támpont kellene, amely nem vonja el a figyelmet a pályáról. Egy hasznos algoritmus értéke ezért nem csak a statisztikai eredményen múlik, hanem azon is, milyen döntést kér az embertől.
Öt ellenőrző kérdés egy szenzoros előrejelzéshez
Amikor hasonló hírt vagy termékígéretet olvasol, először nevezd meg a kimenetet: pontosan milyen lassulást jeleznek? Utána kérdezd meg, ki szerepelt a mérésben, és kit hagytak ki. Harmadik lépésként keresd a különböző találati mutatókat, ne csak a teljes pontosságot. Ezután nézd meg, volt-e új környezetben ellenőrzés. Végül fogalmazd meg, milyen konkrét döntéshez adna neked segítséget a jelzés.
Ezek a kérdések nem az új technológia elutasítását szolgálják. Éppen azt teszik lehetővé, hogy a valóban érdekes eredményt ne keverd össze egy kész fogyasztói szolgáltatással. A derékszenzoros maratoni kutatás értéke, hogy mozgásmintákban keresi a hosszú teljesítményhez kapcsolódó információt. A következő lépés az, hogy ez az információ különböző futóknál, valós döntési helyzetben is megbízhatóan használható legyen.
A saját edzésnaplódban addig is törekedhetsz ugyanarra az alapra: következetes rögzítésre, a körülmények leírására és a bizonytalan jel megjelölésére. Ebből később a szenzoradat is többet érhet. Egy szám akkor segít, ha érted, miből született, milyen eseményre vonatkozik, és milyen döntést tudsz arányosan kapcsolni hozzá.
Források
- Miyazaki és munkatársai: korai IMU-futóadatok és későbbi jelentős tempócsökkenés.
- Smyth: késői maratoni tempóesés nagy adatbázisban.
- Hunter és Muniz-Pumares: élettani paraméterek tartóssága maratonistáknál.
- scikit-learn: osztályozási mutatók és értékelés.
- scikit-learn: adatszivárgás és következetes előfeldolgozás.